OUTILS
Un décodage spéculatif par recherche de motifs plus rapide dans llama.cpp
Un article technique détaille une optimisation du prompt lookup decoding, une méthode de génération accélérée dans llama.cpp.
Hacker News (filtré IA)·@pptadversary·26 septembre 2026
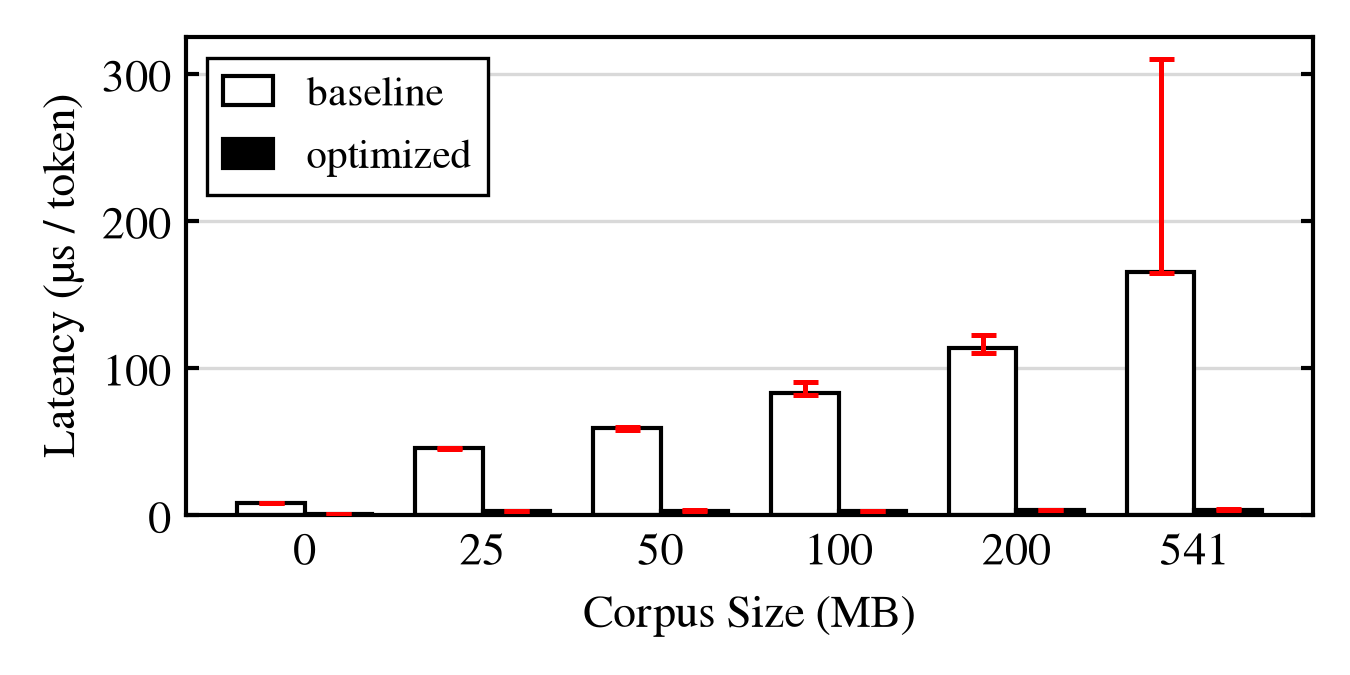
Image · Source originale
L'article présente une amélioration du mécanisme de « prompt lookup decoding » dans llama.cpp, une technique de décodage spéculatif qui accélère l'inférence en réutilisant des séquences déjà présentes dans le prompt plutôt qu'un modèle brouillon séparé. L'auteur explique les optimisations apportées et leur impact sur les performances.
Chaleur 3
Pertinence 55
Nouveauté 40